免责声明:本文为个人技术学习与工程实践笔记,所涉操作仅应在获得授权的环境中进行。因不当使用造成的后果由使用者自行承担。
这是几个月前国外研究者发布的一个挑战;标题本想用中文,但中文标题的 SEO 效果不佳,因此仍使用了英文标题。本文从防御视角梳理该案例的成因与治理思路,涉及的验证环境为挑战方提供的示例程序。
挑战背景
挑战源代码如下,可在本地搭建验证环境。
1 | const express = require('express'); |
这段示例中同时存在两类问题:其一,跳转目标没有做白名单校验,属于任意链接跳转;其二,页面在浏览器端重新从 URL 中取出参数值,并直接用于 location 赋值,一旦取值结果带有伪协议,就会转为脚本执行。代码虽然对跳转地址做了一次等值判断,但这个判断发生在服务端,而真正的取值与使用发生在浏览器端,两者并不共享同一套解析结果,因此问题的关键并不在于如何构造输入,而在于同一段查询字符串被两条解析路径理解成了不同的内容。
解析器差异的成因
浏览器端取值依赖的是 new URLSearchParams(window.location.search).get("redirect_uri")。该 API 的语义非常有限:它只做扁平化的键值切分,get() 会返回与参数名关联的第一个值,既不了解嵌套结构,也不认识方括号。
https://developer.mozilla.org/en-US/docs/Web/API/URLSearchParams/get
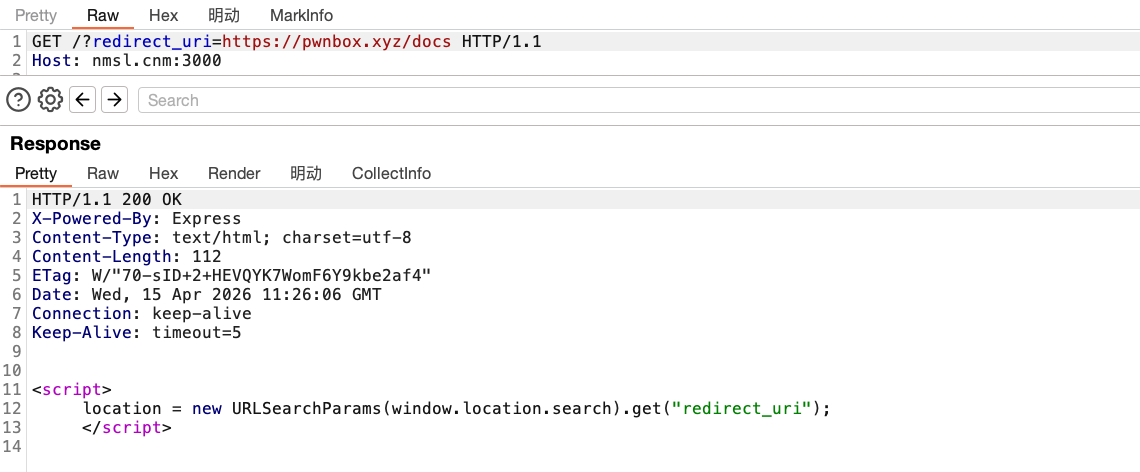
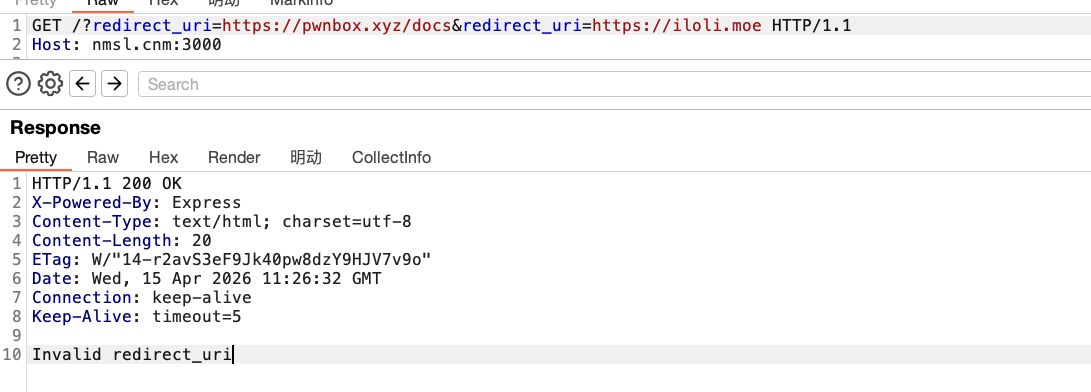
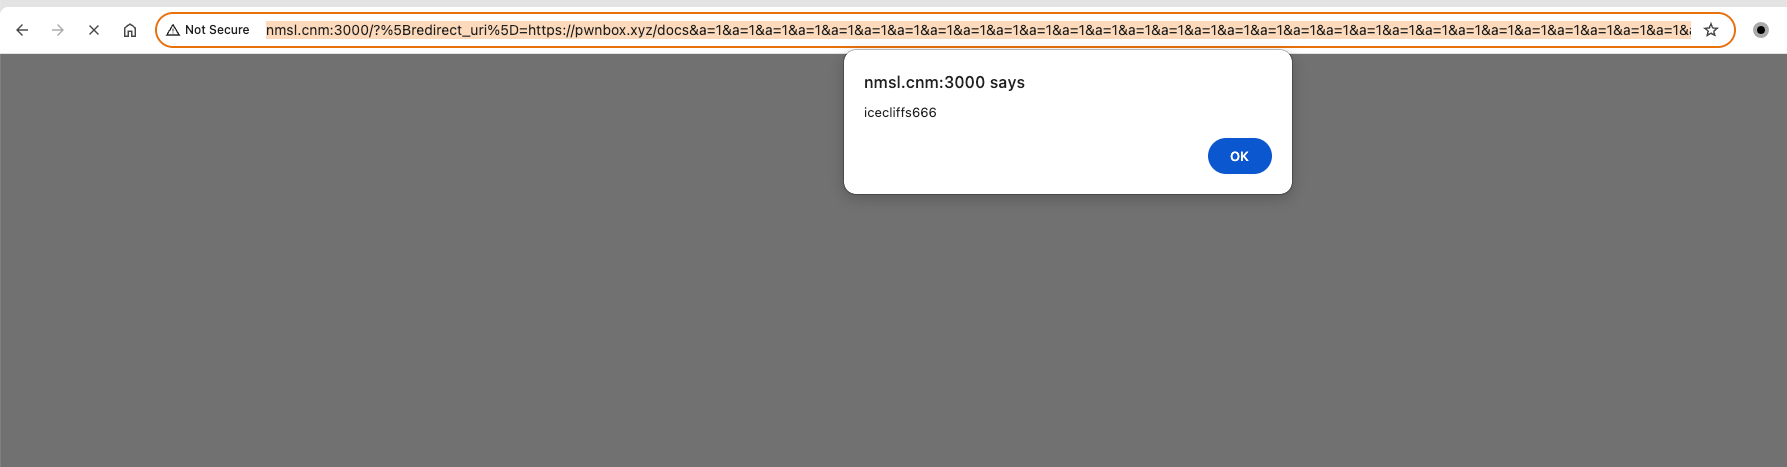
服务端则不同。示例通过 app.set('query parser', 'extended') 引入了 qs 的完整解析能力,例如 foo[x]=bar 会被解析成对象结构;同时 qs 对参与解析的参数个数设有上限(arrayLimit,默认值为 1000),一旦超出该上限,带方括号的键名不再按数组或对象语法展开,而是作为普通字面量键名被保留下来。
两个解析器叠加之后,同一段查询字符串就得到了互不相同的语义:
- 服务端看到的是一个带特殊字符的字面量键名,等值判断因此不通过,校验被”绕过”;
- 浏览器不认识方括号语法,只把它当成一个无关的键名,随后精确命中末尾那个真正名为
redirect_uri的参数,得到伪协议取值并执行。
这正是**解析器差异(parser differential)**的典型形态:校验发生在一条解析路径上,而数据的使用发生在另一条解析路径上,两者对同一输入的理解存在分歧。本例的后果是 XSS,而在其他场景中,同样的分歧也可能造成越权判定、缓存投毒,或请求边界错位一类的问题。因此这类风险的治理重点,不在于让某一条正则表达式覆盖更多字符形态,而在于消除”同一输入、两套解析”的结构。
检测方法
此类问题在流量与日志层面有一定的可观测特征,适合作为常态化监控项:
- 参数数量与长度异常:单次请求的 query 参数个数明显超出业务预期(例如接近或超过千级)、同名参数大量重复、query 总长度远超正常业务值,这类请求本身就很可疑,通常不是正常用户浏览器产生的。
- 编码后的方括号与嵌套语法:请求中出现
%5B、%5D或未编码的[、],以及形如a[b]=c的嵌套键名,应结合业务判断是否属于预期用法。 - 伪协议与跳转行为:在网关或反向代理日志中检索
javascript:、data:、vbscript:等 scheme 出现在查询串或跳转响应中的记录;对存在Location响应头或前端跳转逻辑的端点,记录跳转目标域名分布,出现站外或非白名单域名即为高风险。 - 前端侧信号:启用 CSP 报告(
report-uri/report-to)后,内联脚本或伪协议导航被拦截时会产生告警,可作为此类 XSS 的最后一道发现手段。
检测的前提是能定位到”服务端校验 + 前端二次取值”的代码模式,因此在代码审计与静态扫描中,应把 URLSearchParams、location.search、URLSearchParams.get 与跳转、location 赋值、innerHTML 组合出现的位置列为重点。
修复方案
治理的核心是让校验与使用基于同一份解析结果,而不是去加强单点过滤:
- 不要让前端重新从 URL 取值。服务端完成校验后,应把规范化的结果直接渲染给前端,例如以服务端生成的常量、白名单映射表或签名值的形式下发,前端只做消费,不再解析。
- 跳转目标改为集合枚举而非字符串比对。把允许的跳转地址登记为服务端白名单(键到地址的映射),入参只传递一个标识符,这样任何伪协议或站外地址都无法进入跳转路径。
- 对跳转目标做 scheme 与 host 双重白名单,仅允许
https(必要时http),并在解析后基于规范化后的 host 判断,避免依赖字符串前缀或后缀匹配。 - 统一解析器并收紧解析上限。同一份请求在整条链路中应使用同一种解析方式,避免”网关用一套、应用用另一套”;同时显式设置参数个数与长度上限(qs 的
parameterLimit、arrayLimit,以及网关层的 URL 长度限制),让异常输入在入口即被拒绝,而不是进入业务判断。 - 对渲染位置做上下文相关的输出编码。若确实需要在脚本上下文中使用动态值,应使用 JSON 序列化等方式安全地嵌入,而不是直接拼接字符串。
分层防护
上述修复针对的是应用本身的缺陷,工程上还需要若干层相互独立的控制,避免任何单点失效后直接演变为可利用的 XSS:
- 网关与 WAF 层:URL 长度、参数个数、同名参数数量的硬限制,以及对方括号嵌套语法和常见 scheme 关键字的识别。需要明确的是,这类规则只能拦截已知形态,本例恰恰说明单点过滤的局限——只要解析语义存在分歧,绕过就会以新形态反复出现,因此网关规则应定位为降低噪声与提高攻击成本,而不是安全边界。
- 浏览器侧:启用 CSP,限制
script-src并避免unsafe-inline,可显著降低伪协议导航被用于执行内联脚本的可行性;同时开启 CSP 报告收集,用于发现遗漏的注入点。 - 依赖与组件治理:
query parser、参数解析库的行为会随版本演进(例如默认上限、嵌套语法处理方式的变化),应把这类基础库纳入依赖清单并定期比对版本,避免长期停留在行为不明确的老版本上。 - 最小权限:跳转、渲染类端点通常不需要高权限上下文,应按最小必要原则授权;跳转白名单的配置应由服务端持有并具备变更审计,避免被业务代码随意放宽。
排查清单
结合以上分析,可从以下几步确认系统是否存在同类风险:
- 检索代码中
URLSearchParams、location.search、location.hash的取值位置,确认其是否用于跳转、location赋值或 HTML 拼接。 - 检查服务端是否存在针对同一参数的校验逻辑,并核对该校验所依据的解析方式与前端取值方式是否一致。
- 确认请求解析链路:框架的
query parser配置、网关是否对 query 做过重写或二次编码,是否存在两套解析器。 - 检查是否显式设置了参数个数与长度上限,以及超限时的处理方式(拒绝还是继续解析)。
- 检查跳转类端点是否使用白名单枚举;如仍为字符串比对,按高风险项整改。
- 确认 CSP 与 CSP 报告是否启用,并核对报告接口是否有人跟踪。


